Le pivot : EDIFACT, MCI, JSON
« Les deux représentations décrivent les mêmes messages » : la phrase revient dans chacun de ces articles et elle est facile à écrire. La tenir est autrement plus difficile : deux formats maintenus en parallèle divergent naturellement, à la première évolution appliquée d'un côté seulement. Ce qui l'empêche a un nom : le MCI. Cette page explique ce qu'il est, ce qu'il garantit, et, tout aussi important, ce qu'il ne garantit pas.
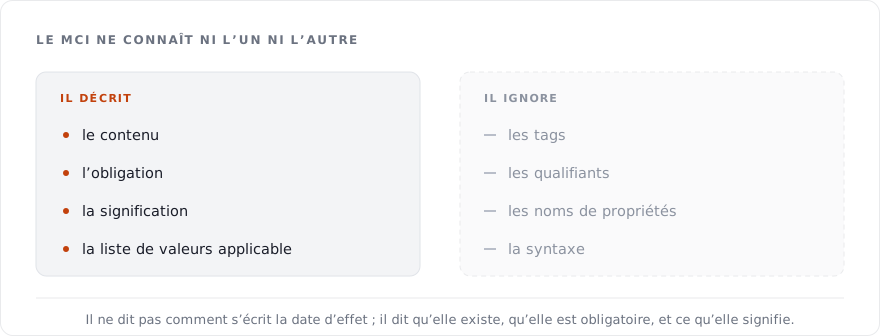
Le MCI décrit un message sans le formater
Un Message Content Inventory est exactement ce que son nom annonce : l'inventaire du contenu d'un message. Il énumère ses lignes sémantiques, chaque donnée que le message peut transporter, avec pour chacune sa description, son caractère obligatoire ou facultatif, sa cardinalité et la liste de valeurs qui s'y applique.
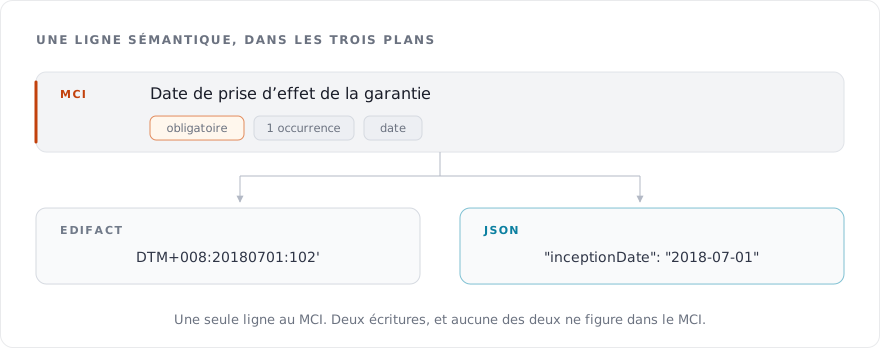
Ce qu'il ne contient pas est aussi important. Aucun tag, aucun qualifiant, aucun nom de propriété JSON, aucun séparateur. Le MCI ne dit pas comment s'écrit la date d'effet d'une garantie ; il dit qu'un certificat de sinistralité en transporte une, qu'elle est obligatoire et ce qu'elle signifie.
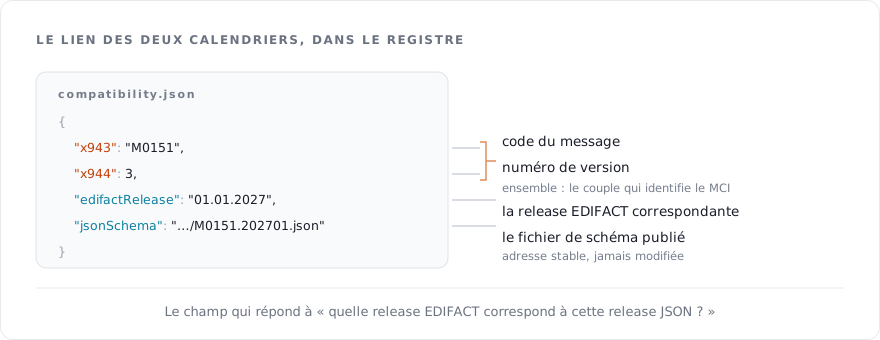
Le MCI est identifié par le même couple que les messages qu'il engendre : le code du message et son numéro de version. C'est ce qui permet de relier sans ambiguïté un MCI, le MIG EDIFACT qui en dérive et le schéma JSON qui en dérive aussi.
Deux dérivations, une seule source
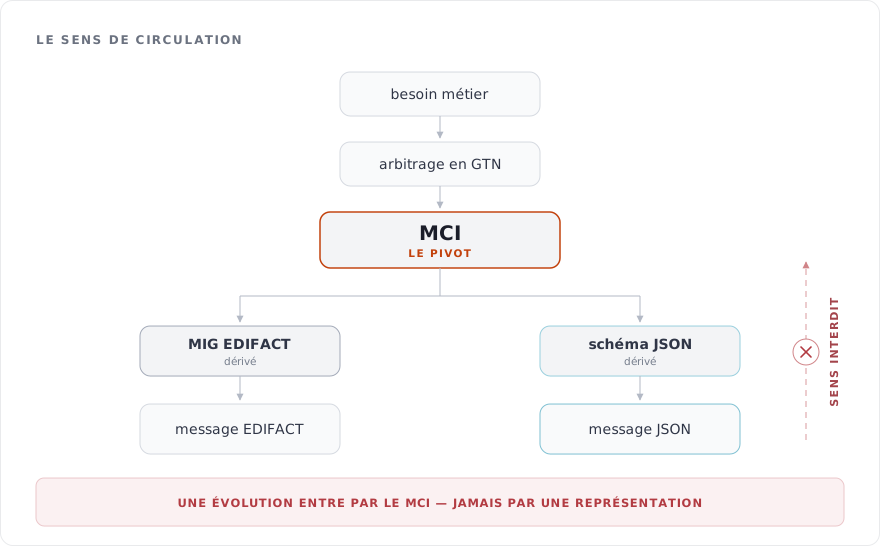
Les deux représentations ne sont pas maintenues en parallèle : elles sont dérivées du même contenu, à partir de la même base de données. Le MIG EDIFACT et le schéma JSON d'un message sont deux projections d'un même inventaire.
Le sens de circulation compte et c'est la règle la plus importante de cette page : une évolution arrive par le MCI. On n'ajoute pas un champ au schéma JSON. On ajoute une donnée au message et les deux représentations en héritent. Une modification appliquée directement à une représentation serait, par construction, une divergence.
Un détail révélateur de cette parenté : les noms de propriétés JSON ne sont pas inventés à la volée. Ils proviennent d'une table de nomenclature partagée avec la représentation XML de la norme. C'est de là que vient l'underscore de "_11", un nom d'élément XML ne peut pas commencer par un chiffre et la contrainte a suivi jusqu'en JSON.
Ce que le pivot garantit
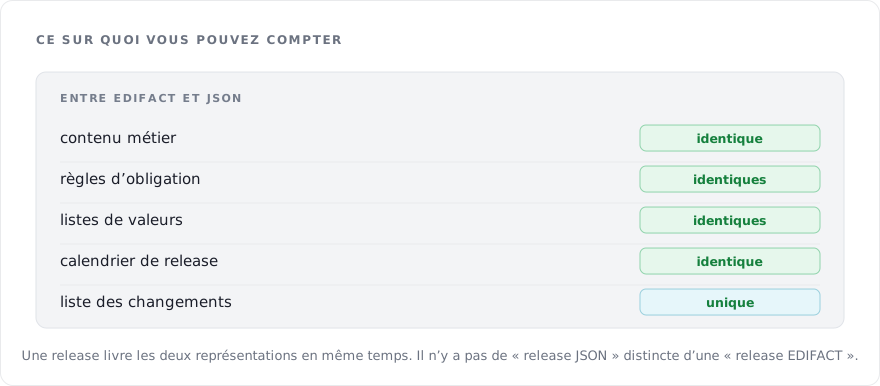
Quatre garanties en découlent et ce sont celles sur lesquelles vous pouvez construire.
Le même contenu métier. Si une donnée existe dans un message, elle existe dans les deux représentations. Aucun format ne transporte d'information que l'autre ignore.
Les mêmes règles d'obligation. Ce qui est obligatoire en EDIFACT l'est en JSON et réciproquement. La contrainte est décidée au niveau du MCI.
Les mêmes listes de valeurs. Les valeurs autorisées pour une donnée sont les mêmes ; seule leur écriture diffère, un code d'un côté, un nom lisible de l'autre.
Le même calendrier. Une release livre les deux représentations en même temps, avec une liste de changements unique. Il n'y a pas de « release JSON » distincte d'une « release EDIFACT ».
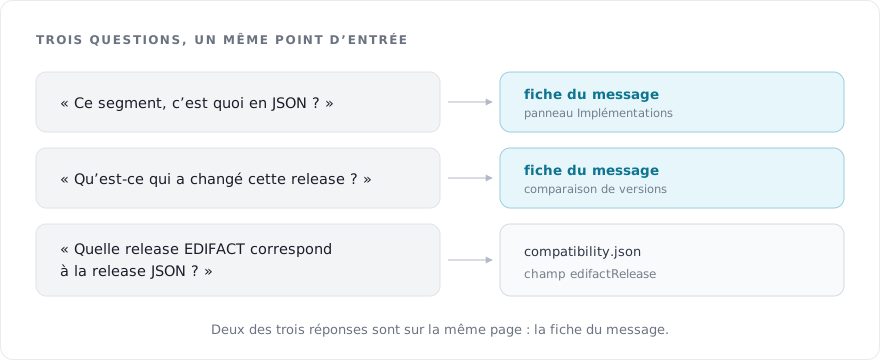
Ce dernier point a une traduction concrète dans le registre : chaque version de message y porte la release EDIFACT qui lui correspond. C'est l'information à consulter quand vos deux chaînes tournent en parallèle.
Ce qu'il ne garantit pas
Trois limites et mieux vaut les connaître avant de bâtir une passerelle entre les deux mondes.
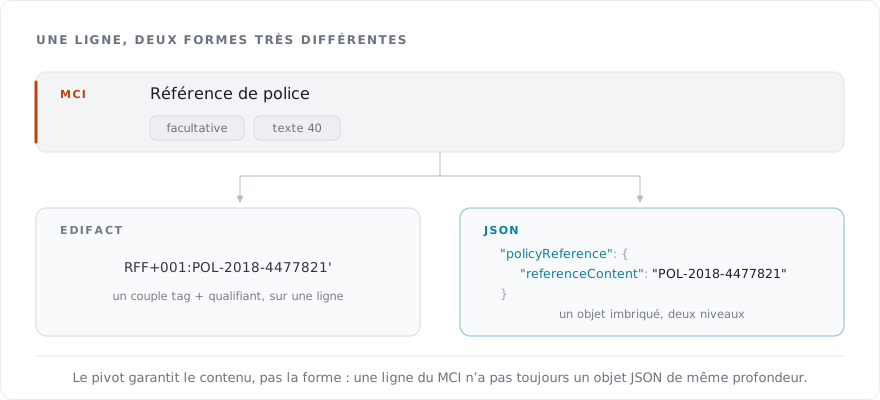
La structure n'est pas isomorphe. Le pivot garantit le contenu, pas la forme. Les groupes de transport d'EDIFACT disparaissent en JSON, les segments récurrents deviennent des composants partagés, un couple tag + qualifiant devient un nom unique. Une ligne du MCI ne correspond donc pas toujours à un objet JSON de même profondeur.
La conversion automatique n'existe pas. Chaque correspondance a demandé un arbitrage : sur le nommage, sur l'aplatissement, sur la représentation des valeurs. Un convertisseur générique qui déduirait l'un de l'autre sans connaître ces décisions produirait du JSON syntaxiquement valide et sémantiquement faux. Les règles et décisions de conversion ont dès lors été écrites, répertoriées et centralisées dans un autre registre. Celui-ci permettra, dans le futur, de concevoir un convertisseur passant d'un format à un autre. Sans ce registre de règles, cette conversion serait difficile voire impossible.
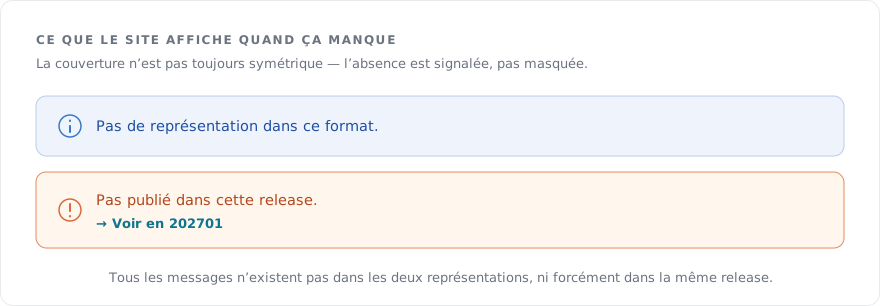
La couverture n'est pas toujours symétrique. Tous les messages n'existent pas dans les deux représentations, ni forcément dans la même release. Le site le signale explicitement plutôt que de le masquer.
Se servir du pivot au quotidien
Le pivot n'est pas qu'un principe d'organisation : c'est un outil de travail et c'est la fiche d'un message qui vous y donne accès.
Elle affiche les lignes sémantiques du MCI et un panneau Correspondance qui pointe vers les deux dérivations, le MIG EDIFACT d'un côté, le schéma JSON de l'autre. C'est le chemin le plus court pour répondre à « à quoi correspond ce segment dans le nouveau format », sans tenir de table de correspondance à la main.
Elle porte aussi une comparaison de versions, qui montre ce qui a bougé d'une release à l'autre. Comme la comparaison se fait au niveau du MCI, elle vaut pour les deux représentations : ce qui a changé pour l'un a changé pour l'autre.
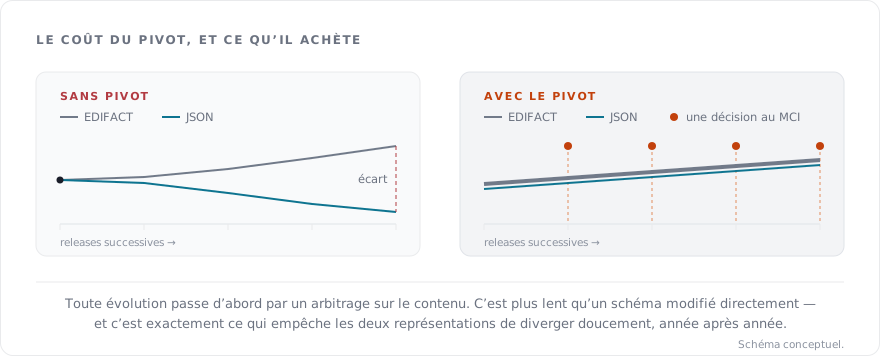
Ce pivot a un coût et il vaut la peine de le nommer. Toute évolution passe d'abord par un arbitrage sur le contenu du message, avant d'être une question de syntaxe. C'est plus lent que de modifier un schéma directement - et c'est exactement ce qui empêche les deux représentations de diverger doucement, année après année, jusqu'à ne plus décrire tout à fait la même chose.